Un site peut être excellent, rapide et rempli de contenus pertinents… s’il n’est pas correctement exploré par les moteurs de recherche, il risque de rester invisible. C’est ici qu’intervient le crawler web, aussi appelé robot d’exploration, spider ou bot.
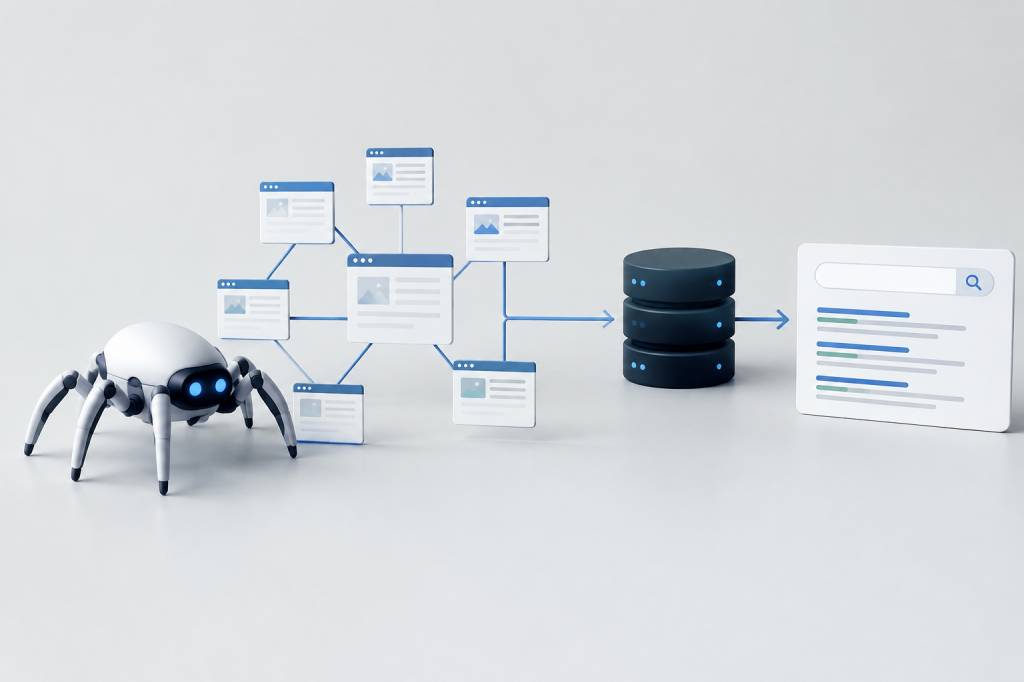
Son rôle consiste à parcourir les pages disponibles sur Internet, à suivre les liens qu’elles contiennent et à transmettre les informations collectées aux moteurs de recherche. Googlebot, Bingbot ou encore les crawlers d’outils SEO travaillent en permanence dans les coulisses du Web.
Mais comment fonctionnent-ils exactement ? Quelle différence existe-t-il entre exploration et indexation ? Et surtout, comment optimiser son site pour faciliter le travail de ces robots ? Voici ce qu’il faut savoir pour intégrer le crawl dans une stratégie SEO solide.
Qu’est-ce qu’un crawler web ?
Un crawler web est un logiciel capable de visiter automatiquement des pages Internet afin d’en analyser le contenu. Il commence généralement avec une liste d’URL connues, appelée ensemble de départ ou “seed URLs”. À partir de ces adresses, il suit les liens internes et externes pour découvrir de nouvelles pages.
Les moteurs de recherche utilisent leurs propres crawlers. Le plus connu est Googlebot, mais il existe également Bingbot, YandexBot ou Baiduspider. Ces robots explorent des milliards de documents et tentent de comprendre :
- le contenu et le sujet de chaque page ;
- la structure du site ;
- les relations entre les différentes URL ;
- la fraîcheur des informations ;
- la qualité et la pertinence des contenus ;
- les éventuels problèmes techniques.
Les outils SEO disposent aussi de leurs propres crawlers. Screaming Frog, Sitebulb, Oncrawl, Semrush ou Ahrefs peuvent parcourir un site pour identifier des erreurs, analyser les liens ou repérer des opportunités d’optimisation.
Attention toutefois : un crawler n’est pas un utilisateur humain. Il ne navigue pas toujours comme nous et ne comprend pas nécessairement une page de la même manière qu’un internaute. Il s’appuie sur le code HTML, les liens, les directives techniques et, de plus en plus, sur le rendu JavaScript.
Comment fonctionne l’exploration d’un site ?
Le fonctionnement d’un crawler repose sur un principe relativement simple : découvrir une URL, la télécharger, l’analyser, puis suivre les liens qu’elle contient. En pratique, les moteurs de recherche utilisent des systèmes extrêmement sophistiqués pour organiser cette exploration.
Lorsqu’un robot arrive sur une page, il commence par vérifier plusieurs éléments techniques. Il consulte notamment le fichier robots.txt, observe les balises de contrôle comme noindex et analyse les liens présents dans le code.
Il peut ensuite :
- enregistrer l’URL dans ses bases de données ;
- extraire les liens vers d’autres pages ;
- évaluer la qualité du contenu ;
- identifier la date de mise à jour ;
- comparer la page avec d’autres versions déjà connues ;
- programmer une nouvelle visite ultérieure.
La fréquence de passage dépend de nombreux facteurs. Un site d’actualité mis à jour toutes les heures sera probablement exploré plus souvent qu’un petit site vitrine rarement modifié. L’autorité du domaine, la popularité des pages, la vitesse du serveur et la qualité de la structure interne jouent également un rôle.
Un exemple concret : vous publiez un nouvel article et vous ajoutez un lien depuis votre page d’accueil. Le crawler peut découvrir rapidement cette nouvelle URL, car la page d’accueil est souvent visitée fréquemment et bénéficie d’une forte visibilité interne. À l’inverse, une page isolée, accessible uniquement après plusieurs clics, risque d’être explorée beaucoup plus tard.
Crawl, indexation et classement : trois étapes différentes
Ces notions sont souvent mélangées, alors qu’elles correspondent à des étapes distinctes du référencement naturel.
L’exploration consiste à découvrir et parcourir une URL. Le crawler récupère son contenu et analyse ses éléments.
L’indexation intervient ensuite. Le moteur de recherche décide s’il souhaite conserver la page dans son index et pour quelles requêtes elle pourrait être pertinente. Une page explorée n’est donc pas forcément indexée.
Le classement correspond enfin à la position de la page dans les résultats de recherche. Il dépend de nombreux critères : pertinence, qualité du contenu, expérience utilisateur, popularité, intention de recherche, signaux techniques et concurrence.
Une page peut donc être :
- explorée et indexée ;
- explorée mais exclue de l’index ;
- non explorée parce qu’elle est difficile à découvrir ;
- indexée, mais mal positionnée sur ses mots-clés.
Cette distinction est essentielle pour diagnostiquer un problème SEO. Si une page n’apparaît pas dans Google, la question n’est pas toujours “comment améliorer son contenu ?”. Il faut d’abord vérifier si elle a été explorée et si elle est bien indexée.
Le rôle du fichier robots.txt
Le fichier robots.txt se trouve généralement à la racine d’un domaine, par exemple https://www.exemple.com/robots.txt. Il sert à donner des directives aux robots d’exploration.
On peut l’utiliser pour limiter l’accès à certaines zones techniques, comme un espace d’administration, des fichiers temporaires ou des paramètres d’URL inutiles. Voici un exemple simple :
User-agent: *
Disallow: /admin/
Disallow: /panier/
Sitemap: https://www.exemple.com/sitemap.xml
Mais attention : robots.txt n’est pas un mécanisme de désindexation. Une URL bloquée dans ce fichier peut parfois apparaître dans les résultats si Google la découvre via des liens externes. Le robot ne pourra pas lire son contenu, mais il saura que l’URL existe.
Pour empêcher l’indexation d’une page accessible aux robots, il faut généralement utiliser la directive noindex dans la balise meta robots ou dans un en-tête HTTP. Il ne faut donc pas bloquer une page dans robots.txt tout en espérant que la balise noindex soit prise en compte : le crawler ne pourra pas accéder à la page pour la lire.
Pourquoi le sitemap XML est important ?
Le sitemap XML fournit aux moteurs de recherche une liste structurée des URL importantes d’un site. Il ne force pas l’exploration, mais il facilite la découverte des pages.
Un sitemap est particulièrement utile pour :
- les sites volumineux ;
- les nouveaux domaines qui disposent encore de peu de liens externes ;
- les sites avec des pages profondes ;
- les boutiques en ligne ;
- les contenus récemment publiés ou fréquemment mis à jour.
Le fichier doit contenir uniquement les URL canoniques, accessibles et destinées à être indexées. Ajouter des pages supprimées, redirigées ou bloquées ne fera que transmettre des signaux contradictoires.
Après sa création, le sitemap peut être déclaré dans robots.txt et envoyé dans Google Search Console. Cette étape permet également de comparer les URL indiquées avec celles réellement indexées.
Le budget de crawl : un enjeu pour les grands sites
Le budget de crawl correspond au volume de ressources qu’un moteur de recherche accepte de consacrer à l’exploration d’un site sur une période donnée. Pour un petit site de quelques dizaines de pages, ce sujet est rarement bloquant. Pour un e-commerce comptant des centaines de milliers d’URL, il devient stratégique.
Les moteurs cherchent à explorer les pages utiles sans surcharger le serveur. Un site qui génère des milliers d’URL similaires, de filtres ou de paramètres peut gaspiller une partie de son budget de crawl sur des pages sans intérêt SEO.
Pour limiter ce gaspillage, il est pertinent de :
- réduire les URL générées automatiquement ;
- éviter les chaînes de redirections ;
- corriger les erreurs 404 importantes ;
- bloquer les espaces réellement inutiles ;
- améliorer les performances serveur ;
- utiliser des balises canoniques cohérentes ;
- maîtriser les facettes et filtres d’une boutique en ligne.
Une anecdote fréquente en audit : un site pense posséder 10 000 pages, mais son CMS en génère en réalité plusieurs centaines de milliers à cause des paramètres de tri, de couleur et de pagination. Le crawler passe alors son temps à explorer des variantes quasi identiques au lieu de se concentrer sur les pages commerciales importantes.
Les bonnes pratiques SEO pour faciliter le crawl
La première règle consiste à construire une architecture claire. Chaque page importante devrait être accessible depuis plusieurs niveaux raisonnables de navigation. Une page stratégique située à dix clics de la page d’accueil n’envoie pas le meilleur signal, même si elle est techniquement accessible.
Les liens internes doivent être rédigés en HTML classique lorsque cela est possible. Un lien avec une ancre descriptive, comme “audit technique SEO”, aide à la fois le robot et l’utilisateur à comprendre la destination.
Il est également important de vérifier les éléments suivants :
- les pages importantes renvoient un code HTTP 200 ;
- les anciennes URL disposent de redirections 301 pertinentes ;
- les liens internes ne pointent pas vers des pages supprimées ;
- les URL canoniques sont cohérentes ;
- les contenus essentiels ne dépendent pas entièrement du JavaScript ;
- les images importantes possèdent un texte alternatif pertinent ;
- la navigation fonctionne sur mobile comme sur ordinateur.
La vitesse du serveur mérite aussi une attention particulière. Un temps de réponse très long peut limiter le nombre de pages explorées et dégrader l’expérience utilisateur. Optimiser le cache, réduire le poids des ressources et choisir un hébergement adapté ne relève donc pas uniquement du confort technique.
JavaScript et rendu des pages
Les sites modernes utilisent souvent JavaScript pour afficher des menus, charger des produits ou générer une partie du contenu. Les moteurs de recherche savent traiter JavaScript, mais ce traitement peut nécessiter plus de temps et de ressources qu’une page HTML directement accessible.
Si le contenu principal n’apparaît qu’après l’exécution d’un script, il existe un risque que le crawler le découvre plus tard ou l’interprète imparfaitement. Ce problème concerne notamment les sites développés avec des frameworks comme React, Vue ou Angular.
La solution n’est pas forcément de supprimer JavaScript. Il faut plutôt vérifier que les contenus essentiels sont disponibles dans le HTML rendu, que les liens sont explorables et que les fonctionnalités critiques ne reposent pas sur des interactions impossibles pour un robot.
Google Search Console, l’outil d’inspection d’URL et les tests de rendu permettent de comparer la page telle qu’elle est affichée à un utilisateur avec celle que Google peut réellement lire.
Comment vérifier le passage des crawlers ?
Plusieurs outils permettent de surveiller l’exploration d’un site. Google Search Console fournit notamment des informations sur les pages indexées, les problèmes rencontrés et les statistiques d’exploration. Les fichiers de logs serveur vont encore plus loin : ils montrent quels robots ont visité quelles URL, à quelle date et avec quel code de réponse.
Une analyse de logs peut révéler qu’un crawler consacre une grande partie de ses visites à des URL inutiles, à des redirections ou à des pages filtrées. C’est une source d’information particulièrement précieuse pour les sites importants.
Les crawlers SEO, quant à eux, simulent l’exploration d’un moteur et permettent de repérer rapidement :
- les pages orphelines ;
- les liens cassés ;
- les contenus dupliqués ;
- les balises title ou meta description manquantes ;
- les problèmes de profondeur ;
- les erreurs de canonicals ;
- les boucles ou chaînes de redirection.
L’idéal est de réaliser un crawl ponctuel après une refonte, puis de mettre en place une surveillance régulière. Les problèmes SEO techniques apparaissent rarement au moment où l’on a le temps de les chercher.
Les erreurs de crawl les plus fréquentes
Parmi les problèmes rencontrés régulièrement, les erreurs 4xx occupent une place importante. Une page supprimée sans redirection peut faire perdre de la valeur aux liens internes et externes qui pointaient vers elle.
Les redirections temporaires mal utilisées, les pages lentes, les boucles de redirection et les erreurs serveur 5xx peuvent également perturber l’exploration.
Autre grand classique : bloquer par inadvertance une section entière dans robots.txt lors d’une migration ou d’une mise en ligne. Une simple ligne mal placée peut rendre invisibles des centaines de pages. Il est donc recommandé de vérifier les fichiers techniques après chaque modification importante.
Enfin, les sites multilingues doivent gérer correctement les versions linguistiques avec des liens hreflang cohérents. Sans structure claire, les moteurs peuvent explorer les pages mais avoir du mal à comprendre quelle version présenter selon la langue ou la localisation de l’internaute.
Une checklist rapide avant de publier
Avant de mettre une nouvelle page en ligne, quelques vérifications simples permettent de partir sur de bonnes bases :
- l’URL est-elle accessible sans connexion particulière ?
- la page renvoie-t-elle un code 200 ?
- est-elle liée depuis une autre page du site ?
- figure-t-elle dans le sitemap si elle doit être indexée ?
- une balise
noindexn’empêche-t-elle pas son référencement ? - la balise canonique pointe-t-elle vers la bonne URL ?
- le contenu principal est-il lisible sans dépendre entièrement d’un script ?
- la page est-elle suffisamment utile pour mériter une place dans l’index ?
Ce dernier point est souvent oublié. Le SEO ne consiste pas à faire indexer toutes les pages possibles, mais à aider les moteurs à identifier les pages qui apportent une vraie valeur aux internautes.
Le crawler, un partenaire à guider
Un crawler web n’est ni un juge ni un magicien. Il applique les signaux qu’on lui fournit. Une architecture confuse, des liens cassés et des directives contradictoires compliquent son travail. À l’inverse, un site bien structuré, rapide et régulièrement entretenu facilite l’exploration et améliore les chances d’indexer ses contenus stratégiques.
La bonne approche consiste à considérer le crawl comme une composante permanente de la stratégie SEO. Lors d’une création de site, d’une migration ou d’une refonte, il doit être pris en compte dès le départ, au même titre que les mots-clés et le contenu.
En pratique, commencez par les fondamentaux : une architecture logique, des liens internes utiles, un fichier robots.txt maîtrisé, un sitemap propre et une surveillance régulière dans les outils SEO. Ce sont rarement les actions les plus spectaculaires, mais ce sont elles qui permettent aux moteurs de trouver, comprendre et valoriser vos meilleures pages.